MBA em Engenharia de Dados
Universidade Presbiteriana Mackenzie
Olá, sou o Vitor.
Sou engenheiro de dados. Trabalho com integração, transformação e modelagem para conectar tecnologia e negócio.
Explore meu trabalho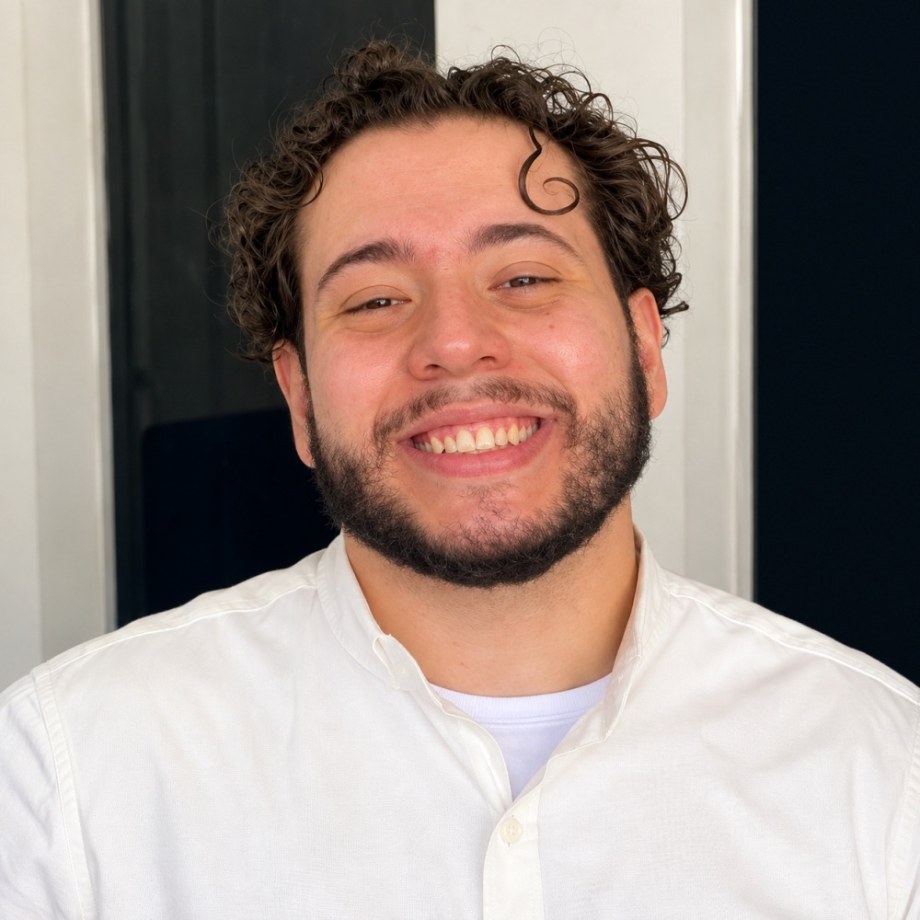
ATUALMENTEMercado Livre desde 2024
SQL, Python e uma visão
além da transformação do dado.
01 / PROJETOS
Quatro trabalhos em engenharia de dados e analytics.
Integração de dados públicos para investigar oportunidades de expansão bancária nos municípios brasileiros.
Como combinar capacidade econômica, adoção digital e presença bancária para comparar oportunidades entre municípios?
Pipeline em camadas raw, trusted e analytics, análise exploratória e três versões do Índice de Potencial Bancário (IPB).
IBGE · BCB · Anatel
Python · raw / trusted
BigQuery · analytics
Integro a equipe com Hermes Augusto, Lúcio Franchi Cruz e Nathalia Miranda. O projeto segue em desenvolvimento, com refinamento e validação de negócio previstos no roadmap.
Dados de vendas e logística organizados em uma plataforma analítica com modelagem, testes e auditoria.
Como transformar arquivos de pedidos e itens em uma base consistente para analisar vendas e logística?
Modelos dimensionais no DuckDB, verificações com dbt, reconciliação de registros e dashboard em Streamlit.
CSV · MinIO
dbt · DuckDB
Streamlit
A arquitetura concentra armazenamento e processamento no ambiente local. O repositório reúne código, documentação de requisitos e planos de teste.
Transformação de dados de e-commerce em dimensões, fatos e análises de vendas por parceiro.
Como organizar pedidos, produtos e parceiros para calcular comissões e comparar o desempenho mensal?
Notebook PySpark com modelo dimensional, agregações mensais, regras de comissão e rankings por parceiro.
Tabelas CSV
Joins · dimensões · fato
Comissões · rankings
Solução desenvolvida em notebook para um desafio de Analytics Engineering. O código documenta as transformações e as regras aplicadas aos dados do exercício.
Preparação de variáveis de crédito a partir de modalidades, vencimentos e faixas de atraso.
Como reorganizar dados no formato SCR para facilitar análises e a construção de variáveis de crédito?
Base analítica book_scr, com agregações por modalidade, faixas acumuladas e exportação em CSV.
SCR · modalidades
SQL · faixas de crédito
Book analítico · CSV
O foco do desafio é a preparação de dados e variáveis para análise de crédito, com consultas exploratórias e exportação da base resultante.
Também por aqui: um projeto de integração e entrega contínuas.
Pipeline CI/CD ↗02 / SOBRE
E-commerce.
Finanças.
Saúde.
Sou engenheiro de dados com uma trajetória que reúne e-commerce, serviços financeiros e saúde.
Trabalho com pipelines, integração, transformação e modelagem de dados. Ao longo dessa jornada, passei por Mercado Livre, Cielo, Magazine Luiza, Itaú, NTT DATA e Optum.
Sou bacharel em Sistemas de Informação e curso o MBA em Engenharia de Dados na Universidade Presbiteriana Mackenzie.
SQL / Python / PySpark
Airflow / dbt / ETL
Google Cloud / AWS / BigQuery
Git / GitHub Actions / CI/CD
03 / TRAJETÓRIA
Data Engineer
Engenharia de dados no ecossistema de e-commerce do Mercado Livre.
— presente
Data Engineer
Atuação em engenharia de dados no setor de meios de pagamento.
—
Analytics Engineer
ETL e pipelines de dados em Google Cloud no projeto Magalu Ads.
—
Data Engineer
Desenvolvimento de processos ETL e soluções serverless na AWS.
—
Junior Data Engineer
Projetos de dados com PySpark, Hive e Tableau.
—
Data Analytics Intern
Análise de dados, SQL e processos ETL no setor de saúde.
—
FORMAÇÃO
Universidade Presbiteriana Mackenzie
Universidade Anhembi Morumbi
04 / CONTATO
Sobre dados, tecnologia
ou o próximo projeto.